Banyak penulis baru menyadari adanya masalah indexing Google Scholar setelah artikel mereka terbit. Saat judul artikel dicari, hasilnya tidak muncul. Pada kasus lain, artikelnya memang ditemukan, tetapi nama jurnal terbaca sebagai judul, nama penulis tidak lengkap, atau artikel bergabung dengan publikasi lain.
Situasi ini tentu membingungkan. PDF terlihat normal ketika dibuka, halaman artikel dapat diakses, dan proses penerbitan sudah selesai. Namun, Google Scholar tidak membaca halaman seperti manusia. Sistemnya menggunakan “crawler” dan parser otomatis untuk mengenali judul, penulis, tahun, nama jurnal, abstrak, serta tautan full text. Jika struktur halaman atau metadata tidak cukup jelas, hasil ekstraksinya dapat keliru.
Artikel ini membahas penyebab umum artikel tidak terindeks Google Scholar, cara memeriksa masalahnya, serta langkah untuk meningkatkan peluang artikel masuk dan terbaca dengan benar dalam Google Scholar indexing.
Apa Arti “Tidak Terindeks” di Google Scholar?
Istilah “tidak terindeks” sering digunakan untuk beberapa kondisi yang berbeda. Sebelum memperbaiki masalah, tentukan dulu :
- Artikel sama sekali tidak ditemukan ketika dicari dengan judul lengkap.
- Artikel hanya muncul ketika dicari berdasarkan nama penulis, tetapi judul atau nama jurnalnya salah.
- Artikel muncul sebagai duplikat dari versi PDF atau halaman lain.
- Nama penulis tidak terbaca sehingga artikel tidak muncul di profil penulis.
- Artikel sudah ada, tetapi sitasi dan pengelompokannya belum diperbarui.
Perbedaan ini penting karena penyebabnya juga berbeda. Tidak semua masalah indexing Google Scholar berasal dari desain PDF. Bisa jadi halaman artikel belum memenuhi pedoman teknis, abstrak tidak mudah diakses, atau metadata bibliografis tidak tersedia.
Studi Kasus: Judul Jurnal Terbaca sebagai Nama Artikel
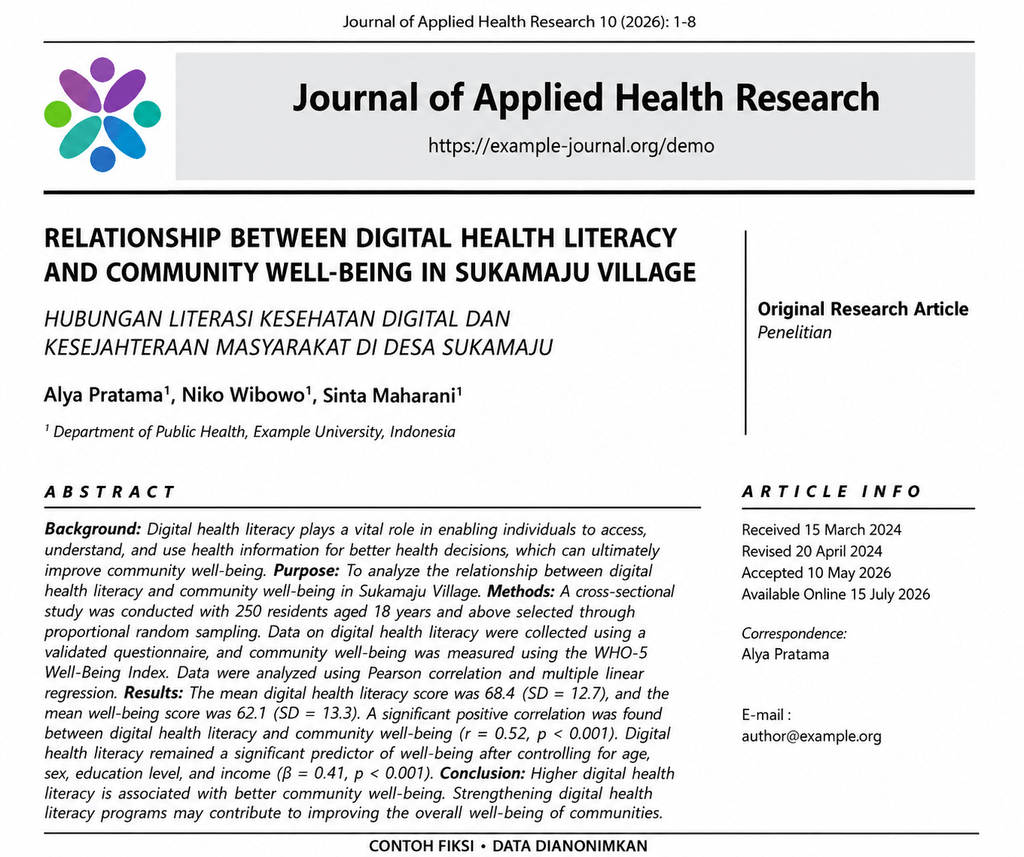
Salah satu contoh yang sering terjadi terlihat pada artikel jurnal dengan desain halaman pertama yang kompleks. Pada bagian paling atas terdapat masthead atau nama jurnal dengan ukuran besar. Di bawahnya baru muncul judul artikel, nama penulis, dan abstrak. Ketika struktur visual ini tidak didukung metadata yang rapi, parser otomatis dapat mengira nama jurnal sebagai judul artikel.
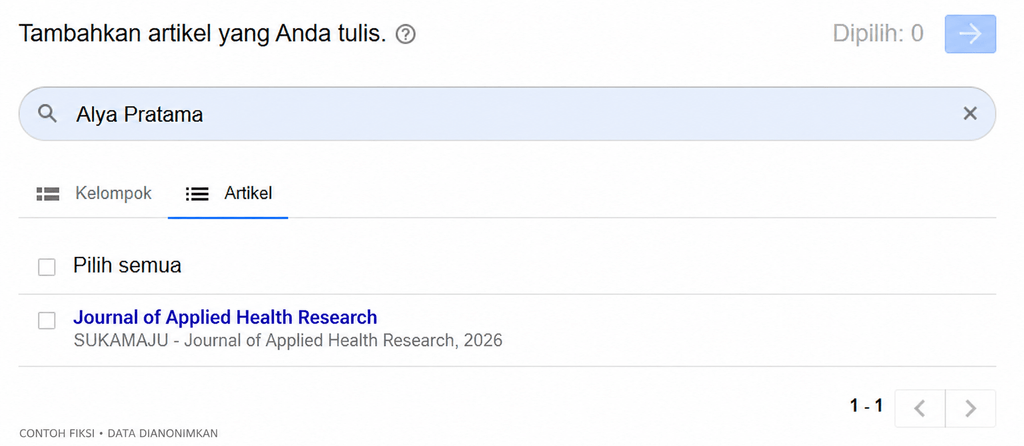
Bagian penting dari studi kasus ini berasal dari keluhan klien kami: jurnal dan artikel mereka sudah terbit, tetapi tidak muncul dengan benar di Google Scholar. Untuk memeriksanya, kami mencari nama salah satu author pada artikel tersebut. Hasilnya menunjukkan masalah yang sangat spesifik: entri yang tampil sebagai judul justru nama jurnal, bukan judul artikel yang sebenarnya. Dengan kata lain, artikel kemungkinan sudah ditemukan oleh sistem, tetapi metadata atau hasil parsing bibliografisnya tidak terbaca dengan benar.
- artikel sulit ditemukan berdasarkan judul asli;
- artikel tidak terhubung ke profil penulis yang tepat;
- sitasi terbagi ke beberapa entri;
- jumlah sitasi dan h-index terlihat tidak akurat;
- pembaca melewatkan artikel ketika melakukan pencarian akademik.
Gambar pendukung menggunakan data fiktif dan sudah dianonimkan. Tujuannya hanya untuk menjelaskan pola masalah indexing Google Scholar tanpa menampilkan identitas author, jurnal, institusi, atau alamat situs yang sebenarnya.
Mengapa Masalah Indexing Google Scholar Bisa Terjadi?
1. Struktur halaman pertama PDF terlalu rumit
Google Scholar menyarankan agar judul artikel berada di bagian atas halaman pertama, diikuti nama penulis pada baris yang jelas. Jika judul bercampur dengan sidebar, kolom informasi, logo besar, atau elemen dekoratif, urutan baca otomatis bisa menjadi ambigu.
Judul yang panjang juga perlu ditempatkan sebagai satu blok teks yang utuh. Hindari menaruh label seperti “Original Research Article” di tengah blok judul atau di posisi yang membuat parser membaca teks secara silang.
2. Masthead jurnal lebih menonjol daripada judul artikel
Nama jurnal boleh tampil pada halaman pertama, tetapi sebaiknya hierarkinya jelas. Judul artikel harus menjadi elemen teks utama, sedangkan nama jurnal, volume, issue, dan label artikel dibuat lebih kecil atau ditempatkan dengan jarak yang mudah dibedakan.
Mengubah logo menjadi gambar dapat mengurangi kemungkinan logo dibaca sebagai teks, tetapi cara ini bukan solusi tunggal. Aksesibilitas, kualitas PDF, dan metadata halaman artikel tetap harus diperhatikan.
3. Meta tag bibliografis tidak tersedia atau tidak akurat
Salah satu faktor terpenting dalam Google Scholar indexing adalah metadata pada HTML halaman artikel. Google Scholar mendukung tag bibliografis seperti citation_title, citation_author, citation_journal_title, citation_publication_date, dan citation_pdf_url.
Setiap citation_author sebaiknya hanya berisi satu nama penulis. Jangan memasukkan afiliasi, gelar, atau nama editor ke dalam field tersebut. citation_title harus berisi judul artikel, bukan nama jurnal atau nama repository. citation_pdf_url harus mengarah ke alamat PDF yang benar dan dapat diakses.
4. Abstrak dan full text sulit diakses
Google Scholar perlu menemukan halaman artikel yang berdiri sendiri. Idealnya setiap artikel memiliki URL unik, abstrak lengkap yang terlihat, dan tautan menuju PDF full text. Jika beberapa artikel digabung dalam satu PDF atau banyak abstrak diletakkan pada satu halaman, proses indexing dapat menjadi kurang akurat.
Artikel dengan akses terbatas juga perlu menyediakan setidaknya abstrak lengkap atau halaman pertama artikel bagi pengunjung yang datang dari Google Scholar, sesuai pedoman teknis Google Scholar.
5. Metadata di dalam PDF masih kosong
Properti dokumen PDF terutama Title dan Author sebaiknya diisi sebelum file diunggah. Metadata PDF bukan pengganti meta tag HTML, tetapi dapat menjadi lapisan informasi tambahan ketika sistem membaca dokumen.
Sebelum ekspor dari Microsoft Word atau aplikasi layout, periksa:
- Title berisi judul artikel lengkap;
- Author berisi nama penulis, bukan nama akun komputer;
- Subject atau Keywords relevan dengan artikel;
- file PDF dapat diseleksi dan dicari teksnya;
- PDF tidak rusak atau hanya berupa gambar tanpa lapisan teks.
Solusi Praktis untuk Penulis dan Pengelola Jurnal
1. Periksa halaman artikel dan URL
- gunakan satu URL unik untuk setiap artikel;
- tampilkan judul artikel dan nama penulis secara jelas di halaman pertama;
- pertahankan urutan baca yang sederhana dan linear;
- sediakan abstrak lengkap pada halaman artikel;
- lengkapi
citation_*meta tags di HTML; - tautkan halaman abstrak ke PDF melalui
citation_pdf_url; - isi metadata Title dan Author pada PDF;
- hindari perubahan URL tanpa redirect yang benar;
- uji beberapa artikel dari setiap issue, bukan hanya satu contoh;
- cek kembali hasil pencarian Google Scholar setelah perubahan diterapkan.
2. Periksa metadata HTML dan metadata PDF
Setelah halaman dan URL diperiksa, lanjutkan ke metadata HTML serta metadata PDF. Pastikan citation_title berisi judul artikel, citation_author memuat satu nama penulis per tag, citation_journal_title berisi nama jurnal, dan citation_pdf_url mengarah ke PDF yang benar. Di dalam PDF, periksa pula properti Title dan Author. Langkah ini perlu dibandingkan dengan judul, author, DOI, volume, issue, halaman, dan abstrak pada halaman artikel agar tidak ada versi informasi yang saling bertentangan.
3. Satukan workflow JATS XML dan PDF layout dengan JATS Editor
Jika semua dikerjakan manual, prosesnya mudah terasa panjang dan rentan terhadap kesalahan kecil. JATS Editor membantu menyatukan pekerjaan tersebut dalam satu workspace. Awalnya dikenal sebagai XML converter dan XML creation tool, JATS Editor kini juga mendukung pengaturan PDF layout dan kebutuhan produksi PDF lainnya, sehingga struktur artikel, metadata, dan tampilan publikasi dapat dijaga tetap selaras dari penulisan hingga ekspor.
Atur struktur artikel dan PDF layout
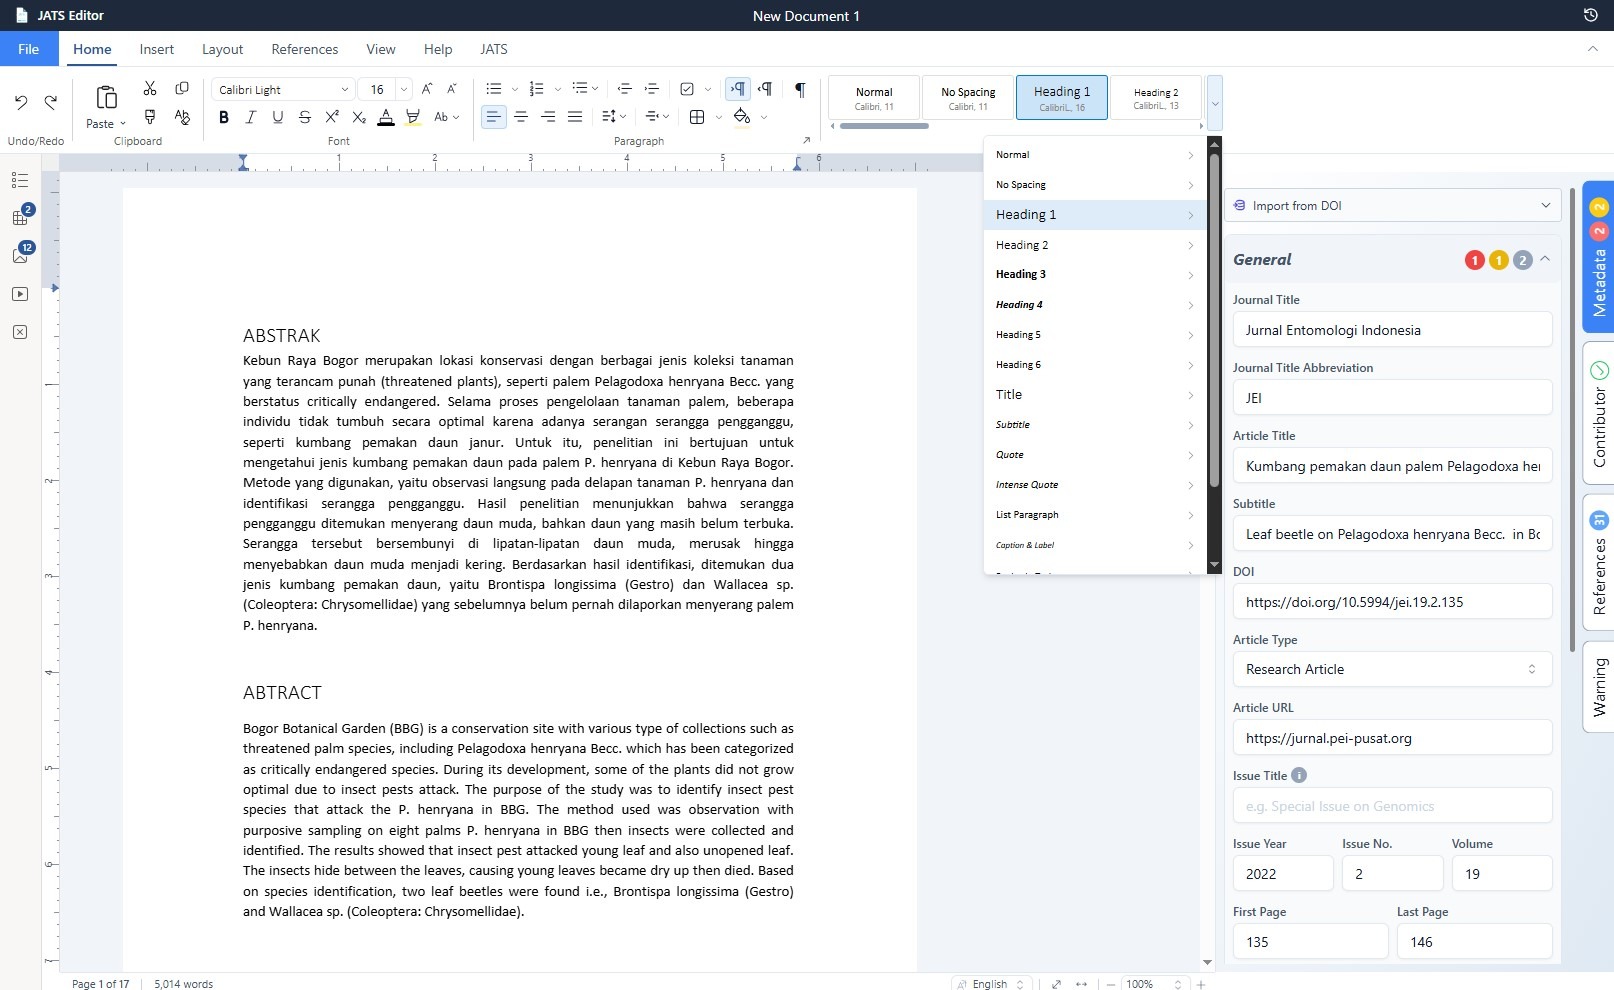
Antarmuka Home dirancang dengan pola editor dokumen yang mudah dikenali. Tim dapat mengatur font, ukuran teks, perataan, spasi paragraf, indentasi, serta gaya dokumen tanpa harus memindahkan naskah ke aplikasi lain. Preset seperti Heading 1 sampai Heading 6, Title, Subtitle, Quote, List Paragraph, dan Caption & Label membantu membedakan fungsi setiap bagian artikel. Penggunaan style yang konsisten membuat hierarki PDF lebih rapi: judul artikel, nama penulis, abstrak, isi, keterangan gambar, tabel, dan referensi memiliki posisi serta penekanan yang jelas.
Jaga metadata artikel tetap konsisten
Panel Metadata menjadi pusat pemeriksaan informasi bibliografis. Di dalamnya, tim dapat menyiapkan Journal Title, Journal Title Abbreviation, Article Title, Subtitle, DOI, Article Type, Article URL, Issue Title, Issue Year, Issue Number, Volume, First Page, dan Last Page. Data ini penting karena judul artikel, nama jurnal, DOI, halaman, dan tautan artikel harus merujuk pada publikasi yang sama. Dengan metadata berada dalam satu panel, risiko perbedaan antara isi PDF, halaman artikel, dan JATS XML dapat dikurangi sejak awal.
Tandai elemen JATS dengan Auto-tag
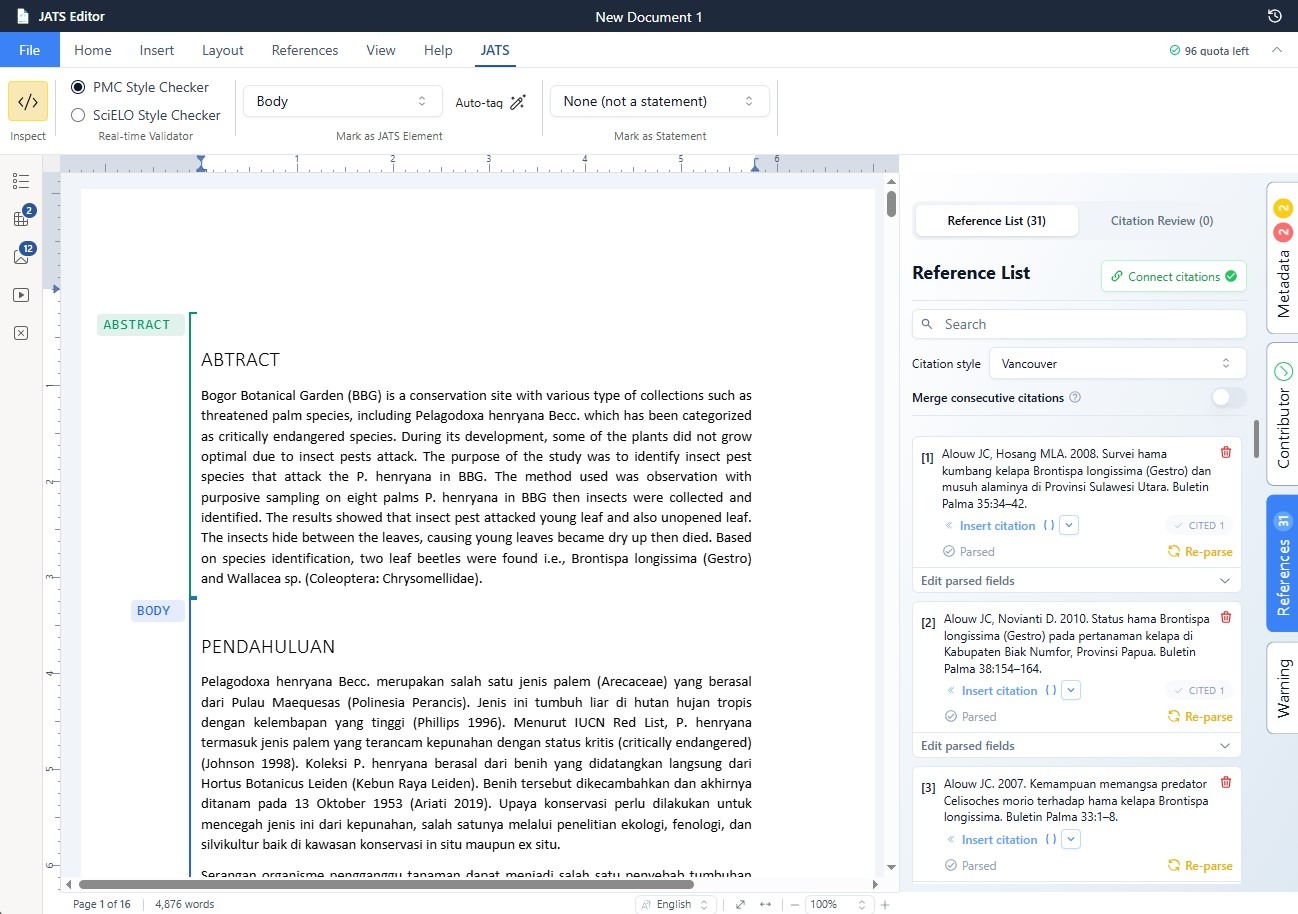
Pada tab JATS, teks dapat dipetakan sebagai Abstract, Body, Reference, atau Ignore JATS. Fitur Auto-tag membantu mempercepat penandaan ketika artikel memiliki banyak bagian. Tim editorial tidak perlu menebak-nebak struktur XML setelah dokumen selesai; elemen penting sudah ditentukan berdasarkan perannya. Selain itu, bagian khusus dapat ditandai sebagai Acknowledgements, Author Contributions, AI Statement, Data Availability, Ethics Statement, atau How To Cite. Hasilnya adalah struktur JATS XML yang lebih bermakna dan lebih mudah diproses oleh workflow publikasi jurnal.
Validasi sebelum ekspor
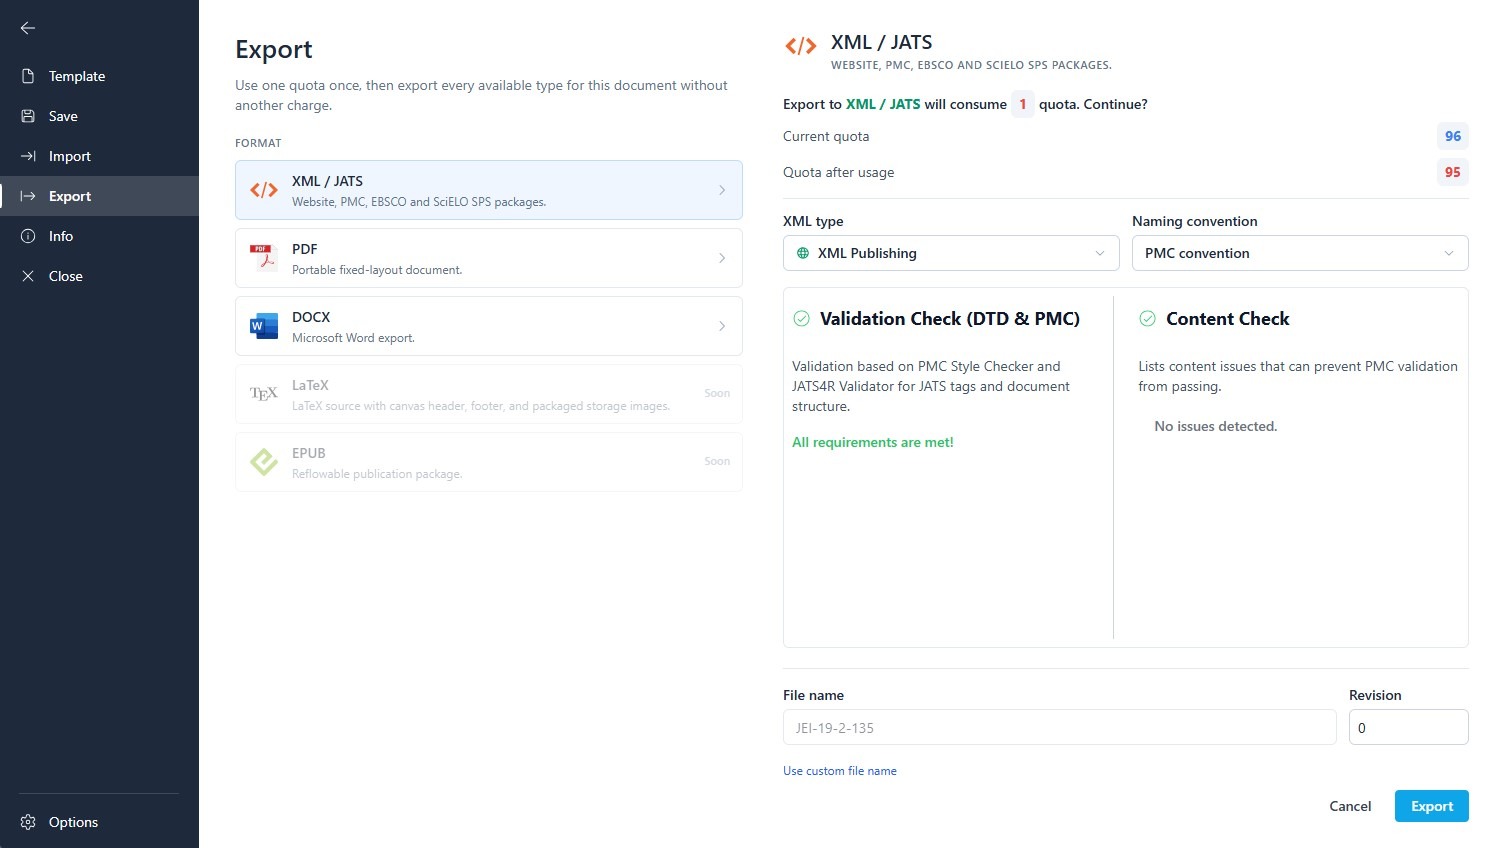
JATS Editor juga menyediakan pemeriksaan gaya secara real-time melalui PMC Style Checker dan SciELO Style Checker. Validator ini membantu menunjukkan bagian yang perlu diperiksa sebelum file dipakai untuk publikasi atau dikirim ke platform indeksasi. Pemeriksaan lebih awal membantu menemukan metadata yang belum lengkap, elemen JATS yang salah tempat, atau struktur artikel yang belum sesuai kebutuhan. Dengan begitu, tim tidak harus menunggu sampai tahap akhir untuk menemukan masalah yang seharusnya bisa diperbaiki saat produksi.
Kelola kontributor, Reference, dan Warning
Panel Contributor membantu mengelola daftar penulis dan informasi kontributor, sedangkan panel References memudahkan pemeriksaan daftar pustaka. Panel Warning berfungsi sebagai pengingat ketika ada bagian yang perlu ditinjau kembali. Kombinasi panel ini membuat proses editorial lebih terarah karena informasi penting tidak tersebar di banyak file atau aplikasi. Tim dapat memeriksa isi, penulis, referensi, metadata, dan peringatan dalam konteks artikel yang sama.
Gunakan satu sumber untuk PDF dan JATS XML
Dalam workflow manual, naskah sering berpindah dari Microsoft Word ke aplikasi layout, lalu ke XML converter, validator, dan alat pemeriksaan metadata. Setiap perpindahan dapat menimbulkan masalah baru: judul berubah, nama penulis tertinggal, tabel bergeser, nomor halaman tidak sesuai, atau tautan PDF tidak lagi menunjuk ke file yang benar. JATS Editor membantu mengurangi perpindahan tersebut dengan menyatukan pengaturan konten terstruktur dan PDF layout dalam satu workflow.
Dengan sumber artikel yang sama, tim dapat menata tampilan PDF sambil menjaga elemen semantik untuk JATS XML. Pengaturan style membantu membangun tampilan PDF yang konsisten, sedangkan metadata dan penandaan JATS menjaga agar informasi bibliografis tetap dapat dibaca oleh sistem publikasi dan layanan indeksasi. Inilah alasan JATS Editor dapat diposisikan sebagai solusi all-in-one untuk kebutuhan XML dan PDF: bukan hanya mengubah dokumen menjadi XML, tetapi juga membantu menyiapkan publikasi yang siap ditinjau, diekspor, dan didistribusikan.
Lakukan pemeriksaan akhir
Walaupun prosesnya lebih terstruktur, pemeriksaan editorial akhir tetap diperlukan. Tim sebaiknya meninjau kembali page break, posisi tabel dan gambar, keterbacaan font, metadata PDF, DOI, tautan full text, serta kesesuaian dengan template jurnal. JATS Editor membantu memusatkan pekerjaan dan mengurangi kesalahan berulang, sementara keputusan akhir mengenai gaya, isi, dan persetujuan publikasi tetap berada pada tim editorial.
Kesimpulan
Masalah indexing Google Scholar biasanya bukan misteri dan tidak selalu berarti artikel ditolak oleh mesin pencari. Sering kali, sistem hanya kesulitan membedakan judul artikel, nama jurnal, penulis, atau versi full text karena struktur visual dan metadata tidak cukup jelas.
Dengan halaman artikel yang memiliki URL unik, abstrak yang mudah diakses, meta tag citation_* yang benar, PDF berteks, serta desain halaman pertama yang teratur, peluang artikel terbaca dengan benar akan menjadi lebih baik. Penulis dan pengelola jurnal juga dapat menggunakan workflow terstruktur seperti JATS untuk mengurangi pekerjaan berulang dan menjaga konsistensi metadata.
Jika jurnal Anda mengalami masalah artikel tidak terindeks Google Scholar, judul salah, atau nama penulis tidak terbaca, mulailah dari audit kecil pada satu issue. Setelah penyebabnya ditemukan, perbaiki template dan alur kerja editorial agar masalah yang sama tidak muncul pada terbitan berikutnya.
Ingin membuat proses publikasi jurnal lebih rapi dan siap untuk Google Scholar indexing? Pelajari bagaimana JATS Editor dapat membantu tim Anda mengelola struktur artikel dan metadata dengan lebih konsisten.